All papers that have not been peer-reviewed will not appear here, including preprints. You can access my all of papers at 🔗Google Scholar.

2026
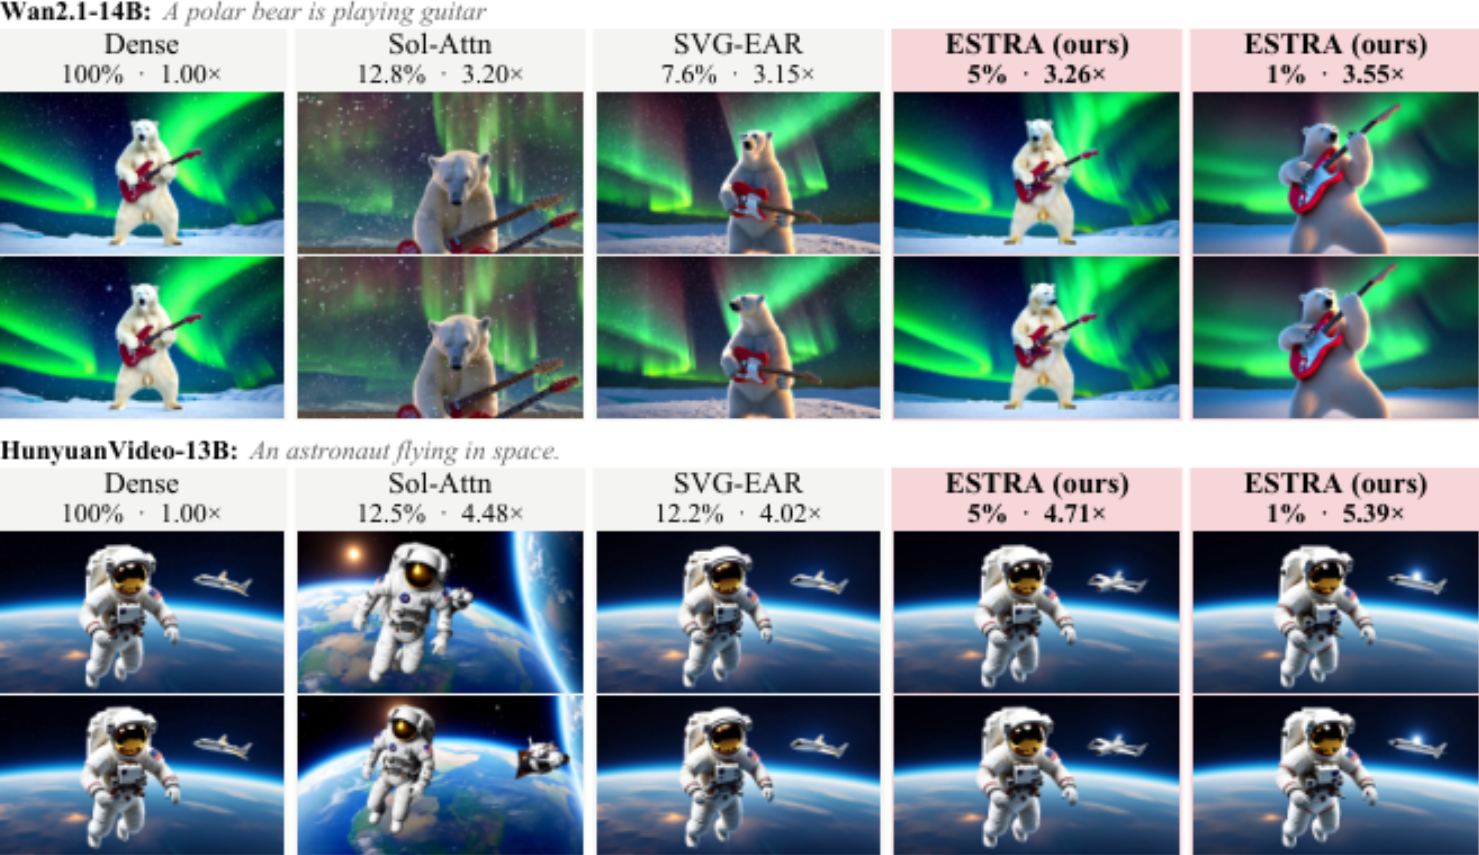
ESTRA: Enabling Extreme Attention Sparsity for Training-Free Video Diffusion Acceleration

Enhuai Liu, Yunke Wang, Yutong Wang, Changming Sun†(† corresponding author)

arXiv 2611.10448

-
ESTRA: Enabling Extreme Attention Sparsity for Training-Free Video Diffusion Acceleration

Enhuai Liu, Yunke Wang, Yutong Wang, Changming Sun†(† corresponding author)

arXiv 2611.10448

-
Auriga Technical Report: A Task-Agnostic Agent Harness for Zero-Shot Embodied Manipulation

StellarEdge AI Technical Team

arXiv 2611.01112 Tech Report

-

Auriga Technical Report: A Task-Agnostic Agent Harness for Zero-Shot Embodied Manipulation

StellarEdge AI Technical Team

arXiv 2611.01112 Tech Report

-

VDOT++: Unified Few-Step Video Generation via Unbalanced Optimal Transport Distillation

Yutong Wang, Xingtong Ge, Enhuai Liu, Yunke Wang, Tianfan Xue, Yu Qiao, Yaohui Wang, Xinyuan Chen†, Chang Xu†(† corresponding author)

arXiv 2610.03221

-
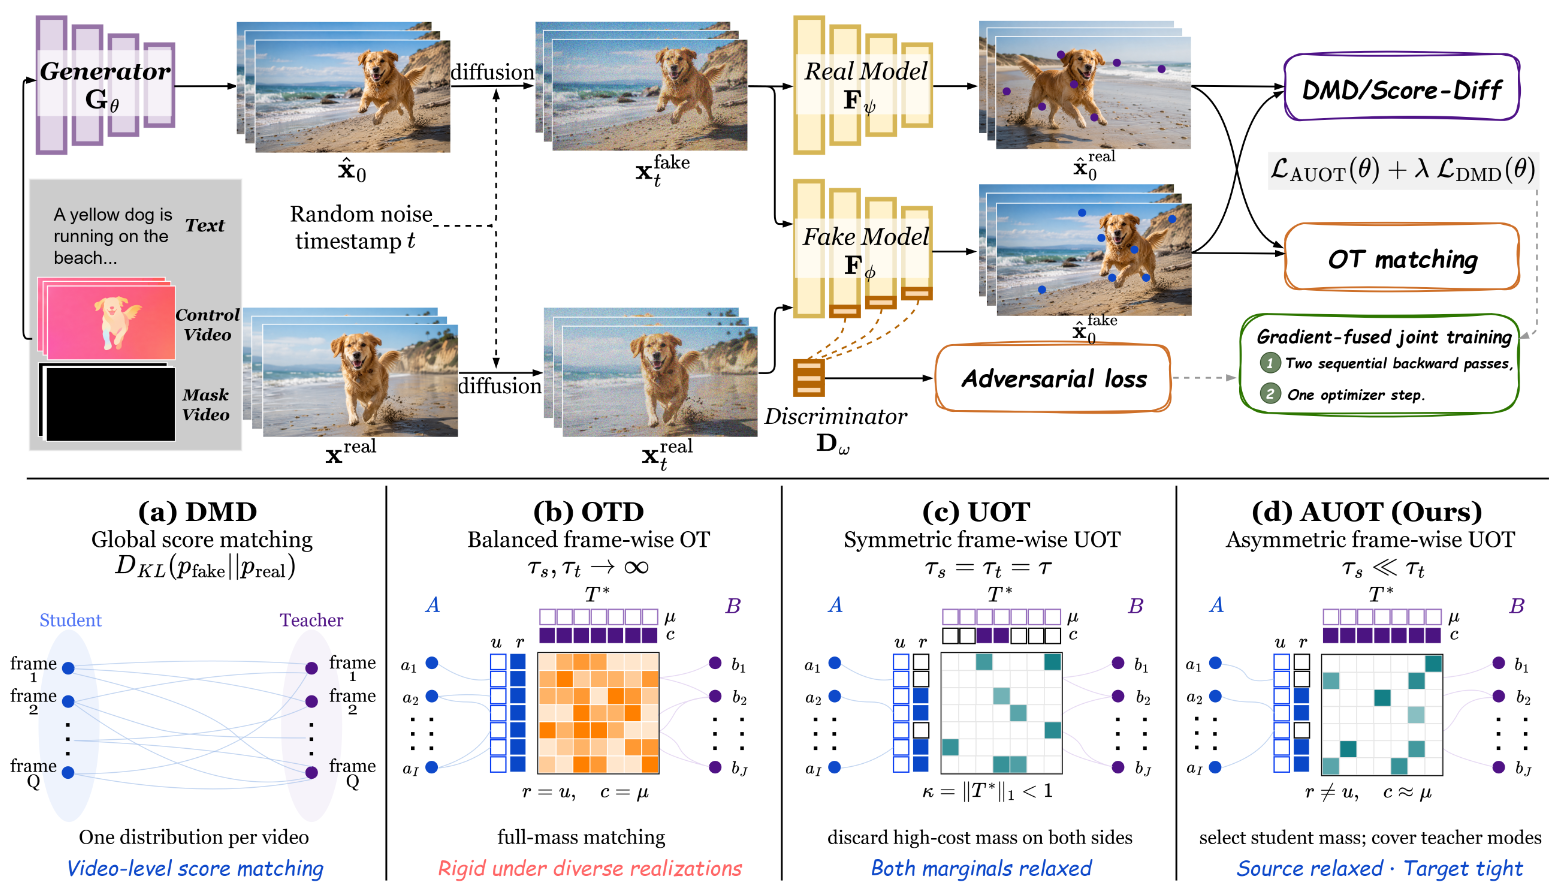
VDOT++: Unified Few-Step Video Generation via Unbalanced Optimal Transport Distillation

Yutong Wang, Xingtong Ge, Enhuai Liu, Yunke Wang, Tianfan Xue, Yu Qiao, Yaohui Wang, Xinyuan Chen†, Chang Xu†(† corresponding author)

arXiv 2610.03221

-

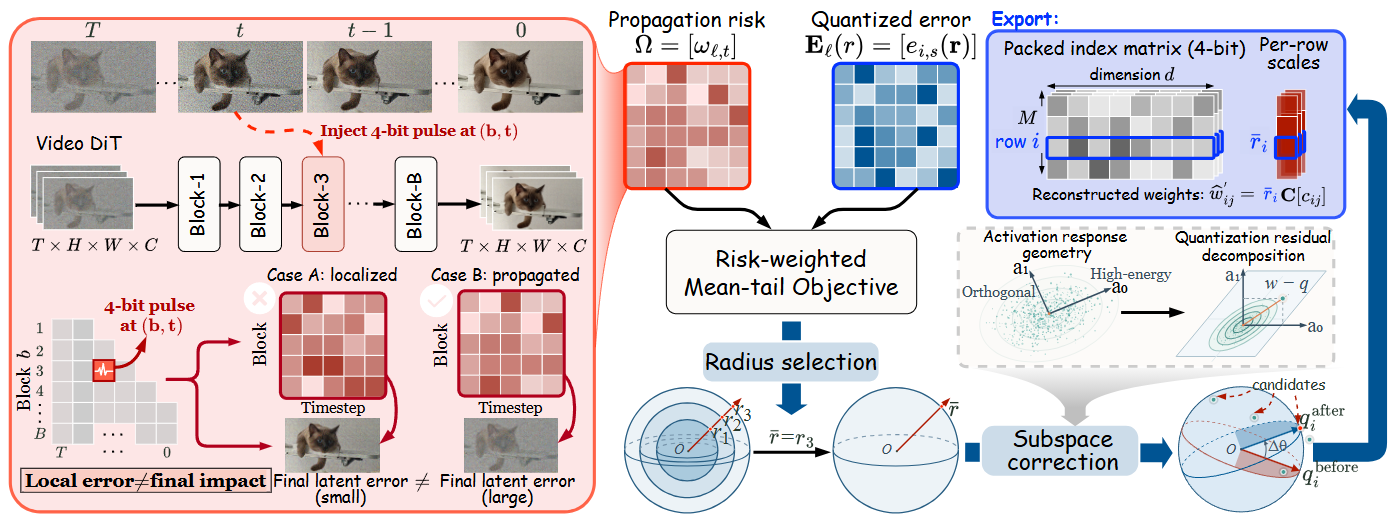
PulseQuant: Propagation-Guided Subspace Correction for 4-Bit Video Diffusion Transformers

Yutong Wang, Xingtong Ge, Enhuai Liu, Yunke Wang, Tianfan Xue, Xinyuan Chen†, Chang Xu†(† corresponding author)

arXiv 2609.33384

-
PulseQuant: Propagation-Guided Subspace Correction for 4-Bit Video Diffusion Transformers

Yutong Wang, Xingtong Ge, Enhuai Liu, Yunke Wang, Tianfan Xue, Xinyuan Chen†, Chang Xu†(† corresponding author)

arXiv 2609.33384

-

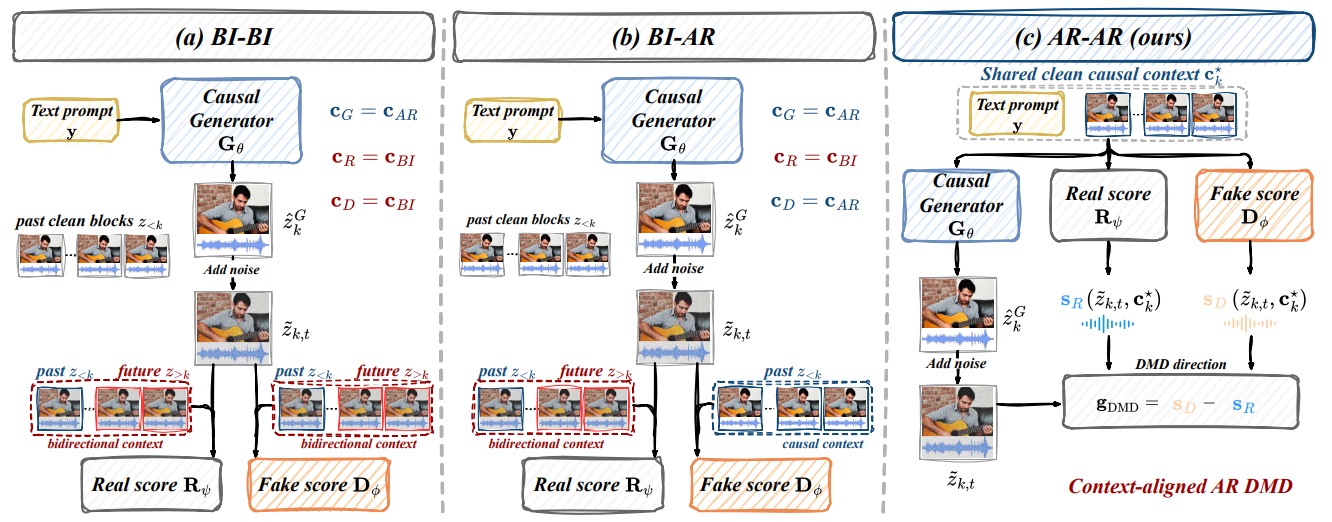
Salt++: Context-Aligned Post-Training for Few-Step Streaming Multimodal Generation

Xingtong Ge, Yutong Wang, Lunjie Zhu, Haitao Lin, Fangyu Lin, Yushi Huang, Xin Zhang, Yi Zhang, Yu Liu, Jun Zhang†(† corresponding author)

arXiv 2609.36995

-
Salt++: Context-Aligned Post-Training for Few-Step Streaming Multimodal Generation

Xingtong Ge, Yutong Wang, Lunjie Zhu, Haitao Lin, Fangyu Lin, Yushi Huang, Xin Zhang, Yi Zhang, Yu Liu, Jun Zhang†(† corresponding author)

arXiv 2609.36995

-

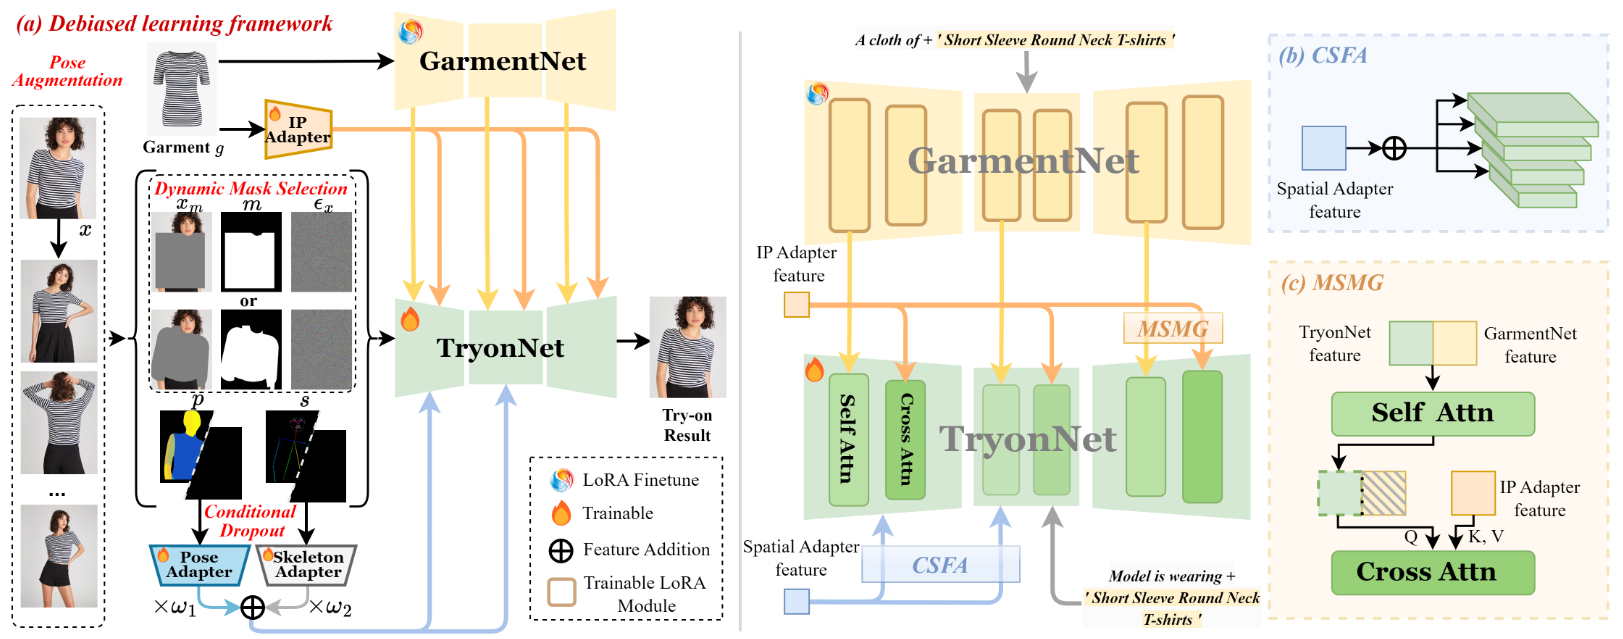
RobustVTON: Robust Virtual Try-on Benefited from Debiased Model Adaptation

Jiaxin Zhang, Dixin Luo†, Jiayi Liang, Yutong Wang, Bohan Zhang, Yingdi Xie, Hongteng Xu(† corresponding author)

The 9th Chinese Conference on Pattern Recognition and Computer Vision, PRCV 2026 Conference

-
RobustVTON: Robust Virtual Try-on Benefited from Debiased Model Adaptation

Jiaxin Zhang, Dixin Luo†, Jiayi Liang, Yutong Wang, Bohan Zhang, Yingdi Xie, Hongteng Xu(† corresponding author)

The 9th Chinese Conference on Pattern Recognition and Computer Vision, PRCV 2026 Conference

-

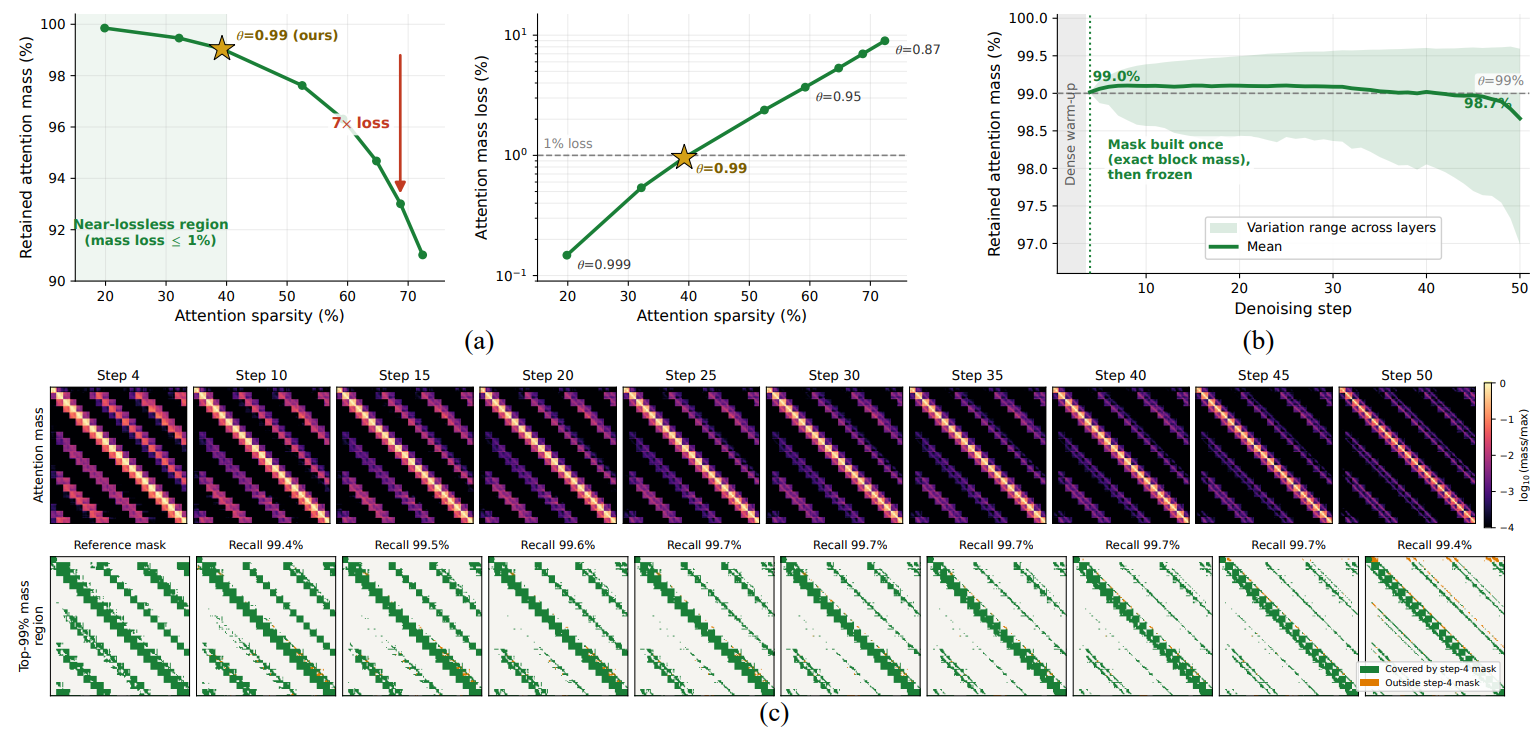
LoSA: Near-Lossless Sparse Attention for Training-Free Video Diffusion Acceleration

Enhuai Liu, Yunke Wang, Yutong Wang, Changming Sun, Chang Xu†(† corresponding author)

arXiv 2608.12032

-

LoSA: Near-Lossless Sparse Attention for Training-Free Video Diffusion Acceleration

Enhuai Liu, Yunke Wang, Yutong Wang, Changming Sun, Chang Xu†(† corresponding author)

arXiv 2608.12032

-

BEAT: Rhythm-Elastic Alignment for Agentic Music-guided Movie Trailer Generation

Yutong Wang, Yunke Wang, Xinyuan Chen†, Chang Xu†(† corresponding author)

arXiv 2605.27067

-

BEAT: Rhythm-Elastic Alignment for Agentic Music-guided Movie Trailer Generation

Yutong Wang, Yunke Wang, Xinyuan Chen†, Chang Xu†(† corresponding author)

arXiv 2605.27067

-

PARE: Pruning and Adaptive Routing for Efficient Video Generation

Yutong Wang, Yunke Wang, Tianfan Xue, Yu Qiao, Yaohui Wang, Xinyuan Chen†, Chang Xu†(† corresponding author)

International Conference on Neural Information and Processing Systems, NeurIPS 2026 Conference

-

PARE: Pruning and Adaptive Routing for Efficient Video Generation

Yutong Wang, Yunke Wang, Tianfan Xue, Yu Qiao, Yaohui Wang, Xinyuan Chen†, Chang Xu†(† corresponding author)

International Conference on Neural Information and Processing Systems, NeurIPS 2026 Conference

-

2025

VDOT: Efficient Unified Video Creation via Optimal Transport Distillation

Yutong Wang, Haiyu Zhang, Tianfan Xue, Yu Qiao, Yaohui Wang†, Chang Xu†, Xinyuan Chen†(† corresponding author)

Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, CVPR 2026 Conference

-

VDOT: Efficient Unified Video Creation via Optimal Transport Distillation

Yutong Wang, Haiyu Zhang, Tianfan Xue, Yu Qiao, Yaohui Wang†, Chang Xu†, Xinyuan Chen†(† corresponding author)

Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, CVPR 2026 Conference

-

Weakly-Supervised Movie Trailer Generation Driven by Multi-Modal Semantic Consistency

Sidan Zhu, Yutong Wang, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the 34th International Joint Conference on Artificial Intelligence, IJCAI 2025 Conference

-

Weakly-Supervised Movie Trailer Generation Driven by Multi-Modal Semantic Consistency

Sidan Zhu, Yutong Wang, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the 34th International Joint Conference on Artificial Intelligence, IJCAI 2025 Conference

-

2024

Efficient Video Face Enhancement with Enhanced Spatial-Temporal Consistency

Yutong Wang, Jiajie Teng, Jiajiong Cao, Yuming Li, Chenguang Ma, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, CVPR 2025 Conference

-

Efficient Video Face Enhancement with Enhanced Spatial-Temporal Consistency

Yutong Wang, Jiajie Teng, Jiajiong Cao, Yuming Li, Chenguang Ma, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, CVPR 2025 Conference

-

An Inverse Partial Optimal Transport Framework for Music-guided Movie Trailer Generation

Yutong Wang*, Sidan Zhu*, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the 32th ACM International Conference on Multimedia, ACMMM 2024 Conference

-

An Inverse Partial Optimal Transport Framework for Music-guided Movie Trailer Generation

Yutong Wang*, Sidan Zhu*, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the 32th ACM International Conference on Multimedia, ACMMM 2024 Conference

-

2023

Self-supervised Video Summarization Guided by Semantic Inverse Optimal Transport

Yutong Wang, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the 31st ACM International Conference on Multimedia, ACMMM 2023 Conference

-

Self-supervised Video Summarization Guided by Semantic Inverse Optimal Transport

Yutong Wang, Hongteng Xu, Dixin Luo†(† corresponding author)

Proceedings of the 31st ACM International Conference on Multimedia, ACMMM 2023 Conference

-

2022

Weakly-Supervised Temporal Action Alignment Driven by Unbalanced Spectral Fused Gromov-Wasserstein Distance

Dixin Luo, Yutong Wang, Angxiao Yue, Hongteng Xu†(† corresponding author)

Proceedings of the 30st ACM International Conference on Multimedia, ACMMM 2022 Conference

-

Weakly-Supervised Temporal Action Alignment Driven by Unbalanced Spectral Fused Gromov-Wasserstein Distance

Dixin Luo, Yutong Wang, Angxiao Yue, Hongteng Xu†(† corresponding author)

Proceedings of the 30st ACM International Conference on Multimedia, ACMMM 2022 Conference

-